Koľko tokenov stojí slovenčina?
Jazykové modely účtujú za tokeny a tokenizéry sa učili hlavne na angličtine. Vložte slovenský text a uvidíte, koľko tokenov a peňazí stojí v jednotlivých modeloch a o koľko viac to je oproti rovnakému textu po anglicky.
Všetko sa počíta vo vašom prehliadači. Text nikam neodchádza.
Mám aj anglickú verziu (presné porovnanie)
Bez anglickej verzie sa porovnanie odhaduje podľa pomeru nameraného na 1012 vetách korpusu FLORES-200.
Cena za 1 000 takýchto textov
Tokeny podľa tokenizéra
Čísla s ≈ sú odhad z nameraného počtu znakov na token. Kliknutím na Spočítať presne sa tokenizér stiahne z Hugging Face (raz, potom ho má prehliadač uložený) a text sa spočíta presne, rovnako ako v benchmarku.
Ako tokenizér delí text
Každý farebný úsek je jeden token. Prerušovaný rámik znamená, že jeden znak (napr. ľ alebo ô) sa rozdelil do viacerých tokenov.
Prečo slovenčina stojí viac?
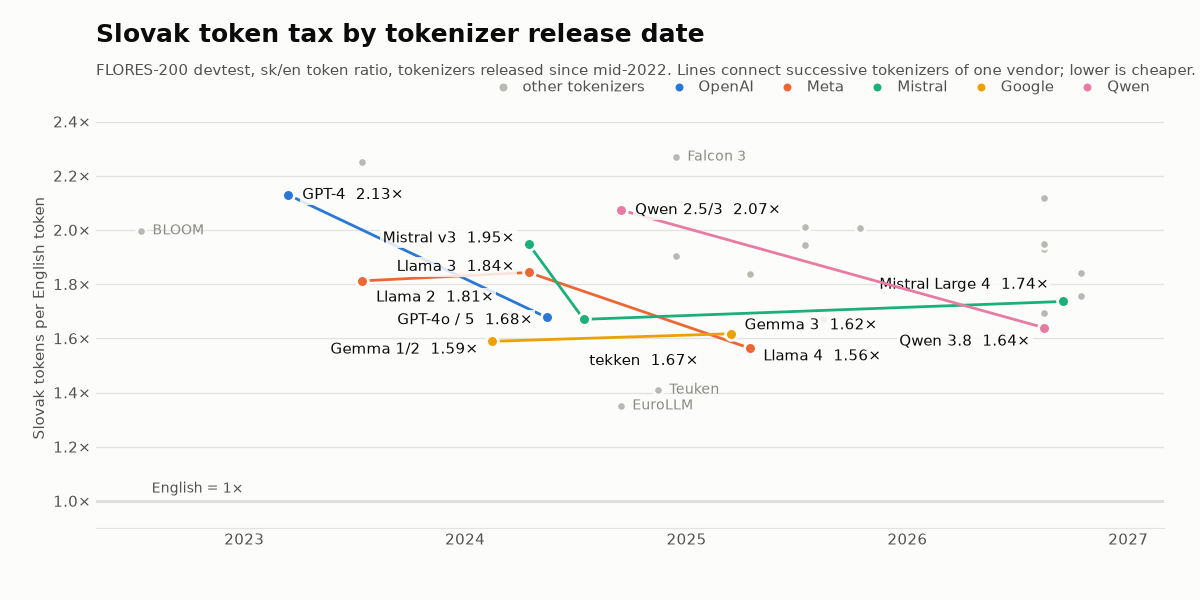
Tokenizér rozdeľuje text na kúsky (tokeny) podľa slovníka, ktorý sa naučil z trénovacích dát. Tie sú prevažne anglické, takže bežné anglické slová sú jeden token, kým slovenské slová s diakritikou a mnohými tvarmi (mesto, mesta, mestu, mestom, mestách) sa rozpadnú na viac kúskov. Za každý token sa platí a každý zaberá miesto v kontextovom okne.
- Bežné modely: slovenčina potrebuje 1,6× až 2,3× viac tokenov ako angličtina (GPT-4o / GPT-5 1,68×, Llama 4 1,56×, GPT-4 2,13×).
- Diakritika nie je hlavný problém: text bez mäkčeňov a dĺžňov ušetrí na moderných modeloch len 1 – 5 % tokenov.
- Je to vecou trénovacích dát: SlovakBERT, trénovaný na slovenčine, potrebuje na slovenský text menej tokenov ako na anglický.
Celé meranie, metodika a výsledky pre 10 jazykov: github.com/ltchurik/sk-tokenizer-bench.